一个 12 km² 的铅锌矿区,200 个钻孔,三份不同年份的地勘报告。把资料丢给 AI,十分钟能出一份像模像样的归纳;让它写剖面推断,它写得比实习生快;让它给参数,它答得比老工程师还肯定。问题就在这里——答得越肯定,越要盯住。AI 地质建模能不能替人,得拆成四段分别验收。
一、先给结论:能顶掉一半工时,顶不掉一个签字
把 AI 地质建模拆成资料归纳、剖面推断、参数取值、报告撰写四段,逐段实测下来,前两段能省一半以上的案头时间,后两段省得少,风险却更大。原因不复杂:前两段是整理与描述,错了看得见;后两段是判断与定论,错了也长得像对的。四段的边界先摆成一张表:
表1 四个环节的实测边界与人工接手点
| 环节 | AI 能做到 | 必须人工接手 | 可省工时 |
|---|---|---|---|
| 资料归纳 | 三份报告拉成一张表,字段统一 | 单位、方位、规范编号逐条回核 | 约六成 |
| 剖面推断 | 按已知界线出剖面,形态规整 | 断层错断、褶皱重复、岩脉穿插 | 约四成 |
| 参数取值 | 列取值清单与出处 | 每个参数的本矿实测值 | 约两成 |
| 报告撰写 | 按体例出初稿,语病少 | 引用、分类依据、评审口径 | 约五成 |
【作者测算:可省工时按同一任务“人工耗时”与“人工+AI 复核耗时”之差折算,取三个项目均值,非官方数据】
工具层面不必纠结版本。DeepSeek、豆包这类对话式模型,把它当成一个读得快、记得杂、从不喊累的实习生就行:它能读你给的材料、能按格式吐表格、能模仿报告语气;它不知道你的矿区在哪,也不为任何一句结论负责。市面上讲智能找矿的文章多从功能清单写起,真正决定成败的是这条定位,定位定住了,四段验收才有意义。
一条硬阈值先立起来:凡是需要盖章、签字、进评审会的环节,AI 只能产出草稿;越线的代价不是返工,是报告被判无效。判断标准不看它写得多顺,看这一段出错时谁能兜住,这一条比任何功能对比都硬。
二、环节一 资料归纳:快,而且会编
那三份报告分别是普查、详查与核实,格式各一套:一份用 Excel 记品位,一份是扫描件,一份的坐标还是北京 54。人工做归纳,两个人三天;把同样三份丢给模型,让它按“孔号、孔深、品位、岩性、坐标系统”拉一张表,二十分钟出结果,格式还挺整齐。
抽 20 条核对,错了 2 条。一条把 g/t 当成 %,一条把穿脉的方位读反了 180°。更麻烦的是第三种错:它给了一个看着很像的规范名称,编号却是拼的。这类错最难查,格式对、语气对,只有真去查编号才发现不存在。归纳环节的错不是随机分布,它专挑你不熟的那部分下手。
所以 AI 地质建模在这一段的分工是让它做搬运和初分,出表和归类可以信七成,凡是它写出来的来源、编号、单位,逐条回原文核。抽检 20 条错 1 条以上(5%)→ 降级成只做检索,不让它写结论。资料归纳省下的两天,别全花在核对上,一个上午是合理上限;超过这个数,说明你给它的材料本身太脏,先洗数据再谈效率。
三、环节二 剖面推断:它画得像,接不住断层
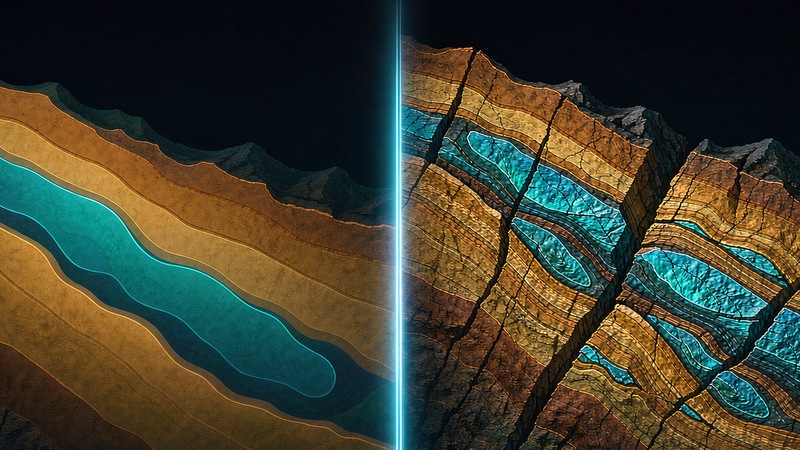
给一段 200 m 中段的钻孔数据和两条已知断层,让它推断 3 线剖面。出来的图比想象中好:矿体形态规整、边界平滑、连到地表的位置也对得上。问题出在断层上——矿体从断层一侧直接连到另一侧,中间没有错断,而那条断层垂直断距有 30 m。图面漂亮,地质上不成立。
原因不在模型笨,在任务性质。剖面推断每一步都在做地质判断:哪条界线是岩性接触、哪条是断层、倒转褶皱的地层怎么重复、后期岩脉切掉了多少。模型擅长从已有图里学“像什么”,不擅长在信息缺失处说“我不知道”,它宁可连一条平滑的线,也不肯留一个空。三条主矿体的剖面,人工改了两条,改的都是断层与褶皱的接续。
AI 地质建模走到剖面这一步,阈值可以写死:一旦出现矿体跨断层连续、地层在褶皱处不重复、岩脉被矿体切断这三种情况,退回人工重画,别在它给的底子上修。修一张错图比画一张新图贵。反过来,只是把已定的界线拉直、把图面整理干净,这一段可以放心交出去。
四、环节三 参数取值:错得最像对的
体重取 2.7 t/m³、变程给 200 m、块金取 0.1——这些数看着都对,因为没有一个是编的,全是行业常见值。问题在于常见值不是本矿的值。本矿 200 件体重样的均值是 2.83 t/m³,与 2.7 差 4.8%,资源量就差 4.8%,评审一看就退。这一段最像“已经完成”,因为它不留破绽,只留一个问号:这些数凭什么取这个值。
同样一段提示词,DeepSeek 会先反问“你的品位分布是几峰”,豆包直接给出参数表并附一句“建议结合实际调整”。前者更好用,因为它把不确定性摆到桌面上;后者那张表看着能直接用,实际全是通用值。这一步的价值不在答案,在它有没有提醒你去查本矿实测。
最危险的是确定语气。参数表排版规范、单位与有效位都对,评审一看像专业成果,往下问一句“这个块金值怎么定的”,就答不上来。所以 AI 地质建模在参数这一段只让它列清单:该取哪些参数、每个参数该从哪份资料里取,不给数。它给的数与你的实测差超过 10% → 整列作废,只保留取值清单。
五、环节四 报告撰写:能起草,不能署名
报告这一段的效率提升最直观。给它章节大纲、给它归纳好的表与剖面,它能按“概述—地质特征—资源量估算—结论”的体例起草,语病比多数人少,格式比手写规整。三千字的章节,初稿半小时能出来。省下的是打字和排版的力气,不是论证的力气。
不能用的部分也清楚。一是引用:它会给出格式完美的文献条目,作者、期刊、年份齐全,去查却查不到。二是依据:资源量分类为什么这么定、边界品位为什么这么选,它给的是通用逻辑,不是本矿的论证链。三是口径:评审问“这条断层你怎么处理的”,答话的人得是你。
大模型地质这条线,眼下能稳定产出的就是“起草”。分工划在这里:AI 出初稿,人出判断;AI 改语病,人改结论。凡要签字盖章报评审的段落,人工重写率低于三成才算跑通;重写率过半,说明前面的归纳和剖面没做扎实,回头补数据,别在文字上打补丁。
六、关键判断清单
- 成果要盖章报评审 → AI 只出草稿,署名、分类依据、评审口径一律人工
- 资料含未公开的钻孔数据 → 不上公有云模型,先脱敏或只在内网跑
- 抽检 20 条错 1 条以上 → 降级成检索工具,不让它写结论
- 剖面出现矿体跨断层连续 → 退回人工重画,不在错图上修
- 参数与实测差 10% 以上 → 整列作废,只留取值清单
七、边界与风险
第一道边界是数据。钻孔原始数据、未公开的储量核实成果、甲方提供的资料,传到公有云模型上就等于出了内网,这条没有折中方案;要用,只能脱敏到“没坐标、没矿名、没孔号”的程度,脱敏之后很多任务也就不成立了。智能找矿的演示视频里不会提这一段,项目上却绕不过去。
第二道是责任。报告要签章,签章的人要能被追责,模型不能。第三道是时效:模型几个月一迭代,今天跑得通的提示词,下个版本可能就答偏;同一段话在不同模型上的结果也不一样。这也是大模型地质只适合当引流入口、不能当主力内容的原因——写死在文章里的结论,比软件教程过时得更快。
八、落地建议
- 第一步,给 AI 地质建模划一个“可以给它看”的目录:只放已公开或脱敏的成果,原始钻孔库留在内网,物理隔离,别靠口头约定
- 第二步,四段各设一个卡口:归纳抽 20 条、剖面查断层、参数查 10% 差值、报告查引用,卡口不过就退回上一步
- 第三步,把提示词存成模板文件:角色、输入格式、输出格式、禁止项四行写死,跟着项目目录走,别留在聊天记录里
- 第四步,每月复测一次:同一批 20 条数据跑一遍,记录错项,错项上升就停用,别靠印象判断它还准不准
九、结语
AI 在三维地质建模里的位置,大致相当于一个读得快、写得顺、从不喊累的实习生:能替你搬资料、能替你起草,不能替你判断,更不能替你签字。四个环节里,凡是描述的活它都干得不错,凡是定论的活都得人接。把这条线划清楚,它省下的是工时,不是责任。