评审现场常见这一幕:模型做得漂亮,块体颜色层层过渡,剖面顺滑得像渲染图,评审只问一句“你这个变程怎么定的”,台上就答不上来。克里格插值被当成精度的同义词用了二十多年,其实它只保证一件事:给定变异函数的前提下,估计无偏、方差最小。变异函数错了,它照样给一张漂亮的错图。
一、方法选错,模型越精致错得越远
一个 3 km² 的银铅锌矿区,200 个钻孔,样品 8 600 条。技术员用默认参数跑完克里格,块体最高品位只有 320 g/t,而钻孔里有 6 个样品超过 900 g/t。换了三个软件版本,结果一样。问题不在软件,在变异函数没拟合、搜索椭球开得过大、极端值被当错样剔掉了。
关键在于:克里格插值不会告你它错了。距离幂次反比法的图粗糙、有牛眼,一眼能看出不对劲;克里格的图平滑、连续、看着专业,错也错得体面。方法越“高级”,错误的伪装越好,这也是它最危险的地方。
所以可信度不能靠看图判断,得算。三条腿:数据质量、方法适配、验证闭环,缺一条结论就得降级。数据质量看孔距与样品代表性,方法适配看分布形态与样品数量,验证闭环看有没有做过留一法交叉验证,三项都没有一处能靠软件默认值糊过去。
二、变异函数三个参数,各自管什么
变异函数是地质统计学的入口,也是最多人跳过的一步。三个参数各管一件事:块金是间距趋近于零时的方差,管微观随机性——取样、分析、矿化的微观跳动都在这里,块金偏大意味着任何插值都会抹掉细节;基台是曲线趋平的那条水平线,等于样品总方差,管整体波动幅度;变程是曲线首次到达基台的距离,管“多远之内还有相关性”。
这三个数不是拟合出来就完事,要拿去和地质对一遍。某铁矿实测变程 180 m,勘探线距 60 m,说明沿线方向三个线距内都有相关性,圈定资源量时块体尺寸不能超过 60 m;另一条垂直走向方向拟合出 70 m,两个方向差 2.5 倍,这就是各向异性,搜索椭球得按 240 m×160 m×40 m 开,不能开成一个球。
拟合本身有讲究。球状模型适合多数金属矿,指数模型适合有方向性连续性的矿化,高斯模型过于平滑,容易在变程附近造出虚假的连续带。经验做法是先算实验变异函数,按 lag 分组,lag 间距取最小采样间距的 2–3 倍,再拿球状模型去试;拟合残差大,先怀疑样品组合没做——把 1 m 的样品组合成 2 m,曲线会明显更规整。
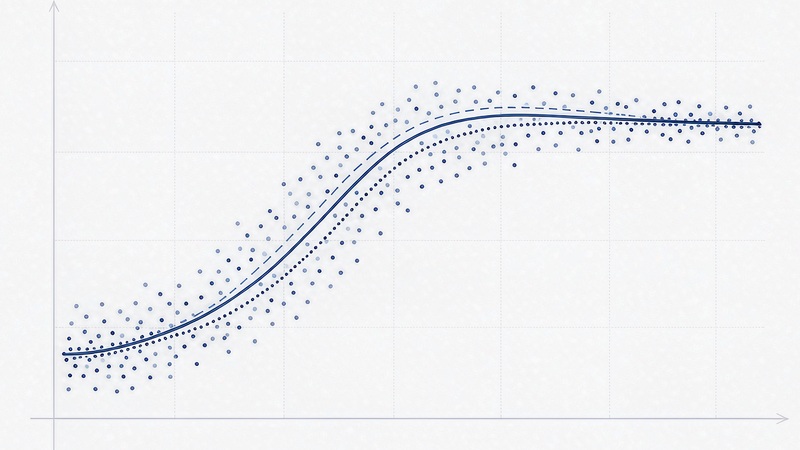
变异函数拟合方法说到底是三步:算实验曲线、按 lag 分组、选模型试拟合,每一步都能被复核。拟合好坏有个粗糙但有效的判据:变程超过矿体长轴的 1/2,多半是样品太少撑不起曲线;变程小于勘探线距,说明拟合的是取样噪声,不是矿化。两种情况都不该直接上克里格。
三、方法怎么选:一张表定下来
克里格与距离幂次反比法区别,说到底是“要不要先建一个空间相关性模型”。克里格插值原理里那套权重方程的来路值得先读懂。距离幂次反比法只认距离,权重是负幂,简单、稳、不会崩;克里格多走一步,先描述相关性再分配权重,代价是要拟合、要检验、要人判断。
样品数、分布均匀度、是否服从正态,三个条件决定用哪个方法。被问得最多的是克里格与距离幂次反比法区别,答案其实就藏在下面这张表里:
表1 三种插值方法的适用条件与代价
| 方法 | 样品条件 | 分布要求 | 主要代价 |
|---|---|---|---|
| 距离幂次反比 | 少于 30 个孔或样品 <500 条 | 不限,极值可直接参与 | 有牛眼效应,无法给误差 |
| 普通克里格 | 30–200 个孔,孔距较均匀 | 需去趋势,量级差异大时先做正态得分变换 | 平滑效应,极值被压制 |
| 序贯高斯模拟 | 样品充足且需评估不确定性 | 必须做正态得分变换 | 耗时高,每次实现都不同 |
样品少于 30 个孔,别硬上克里格。这不是保守,是数学:变异函数的三个参数靠样品对支撑,孔太少时实验变异函数全是散点,拟合出来的曲线更多反映你的想象。这时候用距离幂次反比更诚实——它不假装知道自己不知道的事。
另一种常见错配是有明显趋势的沉积型矿体直接用普通克里格。品位随标高单调变化,变异函数会被趋势污染,拟合出的变程虚高。做法是先拟合趋势面剔除,再对残差做克里格,再把趋势加回去,这一步不做,模型在中段会系统偏高。
四、克里格为什么把高品位抹平
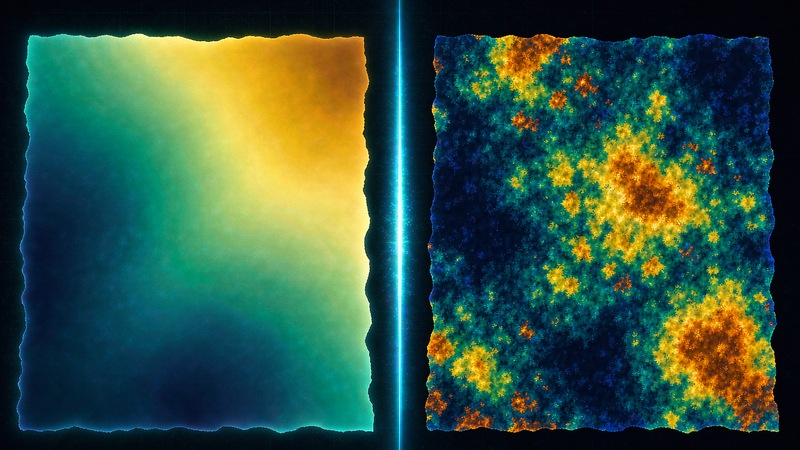
克里格是 BLUE——最优线性无偏估计,这也是普通克里格与简单克里格区别的根源:前者估局部均值,后者假设均值已知。三个词里,“线性”和“无偏”好理解,“最优”指的是估计方差最小。问题正出在这里:为了让整体的估计误差平方和最小,它会把偏离周围样品的值往均值方向拉。一个 900 g/t 的样品被 8 个 80 g/t 的样品包围,克里格给它所在的块体估出 150 g/t 左右,因为它判定这个高值大概率是局部富集,不代表整个块体。
这不是 bug,是设计目标。资源量估算要的是块体平均品位,不是点品位,抹平在统计上是正确的。代价是三个:高品位段的资源量被系统性低估、品位-吨位曲线的头部被削、矿体边界被模糊。某金矿用克里格估完,品位 >5 g/t 的块体占 4.2%;换成序贯高斯模拟跑 50 次实现,同一阈值下在 3.8%–6.1% 之间波动,真实的不确定性被克里格压成了一个数字。序贯高斯模拟补的正是这块方差,不是精度。
所以看到克里格模型,第一个该问的不是“怎么这么平滑”,而是“平滑掉了多少”。做法很简单:取高品位段的块体,把原始样品按同一范围统计,两者均值差超过 20%,就要在报告里写明这是平滑效应,并在资源量分类时把该段降级。
五、验证与分级:A/B/C 怎么打
验证不是跑个交叉验证就完事。留一法交叉验证的做法是逐个剔除样品、用其余样品估计它,再统计误差。三个数必须一起看:均值误差接近 0 说明无系统性偏差,误差方差与克里格方差接近说明模型自洽,估计值与实测值的相关系数反映整体趋势。某铜矿的实测值是均值误差 -0.02、相关系数 0.71,看着合格;再看 QQ 图,中间段贴合、两端明显偏离,说明高品位端被低估——这种情况相关系数再高也不能给 A。
可信度分级按三条腿过关的程度定,别按工作量定,变异函数拟合方法是否经得起复核,是第一道筛子:
表2 三维模型可信度分级与适用边界
| 等级 | 数据条件 | 验证要求 | 可支撑的用途 |
|---|---|---|---|
| A | 孔距 ≤ 勘探线距,样品 ≥1 000 条 | 交叉验证通过,QQ 图两端贴合 | 资源量估算与分类 |
| B | 孔距 1–2 倍线距,样品 300–1 000 条 | 均值误差与相关系数合格,QQ 图尾部有偏离 | 采剥设计参考、方案比选 |
| C | 孔距 >2 倍线距或样品 <300 条 | 仅做量级核对 | 示意、汇报、投标附图 |
分级的意义在于把话说清楚。C 级模型不是废品,是不能拿去算储量;B 级模型不是不能用,是不能写进储量核实报告。很多项目的争议不在技术,在拿 C 级的图去支撑 A 级的结论,评审一追问数据条件就露馅。
六、关键判断清单
- 样品少于 30 个孔 → 用距离幂次反比,别拟合变异函数
- 变程大于矿体长轴 1/2 → 数据不足,先补孔再谈克里格插值
- 变程小于勘探线距 → 拟合的是噪声,重做样品组合
- 高品位段块体均值比样品均值低 20% 以上 → 报告中写明平滑效应并降级
- QQ 图两端偏离 → 不给 A 级,无论相关系数多高
七、边界与风险
数据体检不过关,后面所有参数都是空转,钻孔数据体检清单那种逐项排查比调参有用。第一道边界是时间:克里格插值、交叉验证、参数调优一套走完要三到五周;项目只有两周时,硬上克里格的代价是结果全没验证过,比用距离幂次反比出一张诚实的中等精度图更危险。
第二道是极端值。特高品位处理不当,要么被当成错误样删掉(资源量系统性偏低),要么直接参与估值(块体被拉出虚假富集中心)。正确做法是封顶或截断,把品位压到第 98 百分位附近,并记录处理前后的资源量差。
第三道是各向异性的方向。搜索椭球的方向靠地质认识定,软件给的默认值常常是水平面内各向同性,对陡倾矿体是灾难——沿倾向的连续性被截断,模型出来的矿体像千层饼。这类错误在图上不明显,在剖面上很明显,验收时一定要切一张垂直走向的剖面看。
八、落地建议
- 第一步,先做数据体检:孔距、样品长度、特高品位条数、坐标系统四项,任何一项有问题,后面的参数都不可信
- 第二步,实验变异函数按三个方向分别算,lag 间距取最小采样间距的 2–3 倍,先看曲线形状再谈拟合
- 第三步,同一批数据跑两套:距离幂次反比做基准,克里格做对比,两者资源量差超过 15% 就回头查参数
- 第四步,留一法交叉验证必做,均值误差、相关系数、QQ 图三个一起看,缺一项不给 A 级
- 第五步,把分级写进成果表头:A 级支撑储量,B 级支撑设计,C 级只做示意,别让下一手用错
九、结语
克里格插值能给你一张无偏的图,前提是变异函数先对了。地质统计学的价值不在“高级”,在于它把空间相关性写成了可检验的参数,让人能追问、能复核。可信度也不是算出来的一个分数,是数据、方法、验证三条腿站住之后,别人问什么你都能答上来。