做了十五年固体矿产和能源矿产勘查,我见过的 AI 找矿项目,十个有八个不是死在模型上,是死在数据上。地质数据清洗说起来枯燥,却决定了后面每张图的成色。先给结论:数据比算法更贵——一套标错的化探数据,换三个模型都救不回来;一套干净、配准准确、样本分得清的数据,用最朴素的随机森林也能出靶区。这篇讲地、物、化、遥四类数据从原始表到训练集的四道工序,顺序错了就要返工。
一、四类数据各有各的“脾气”
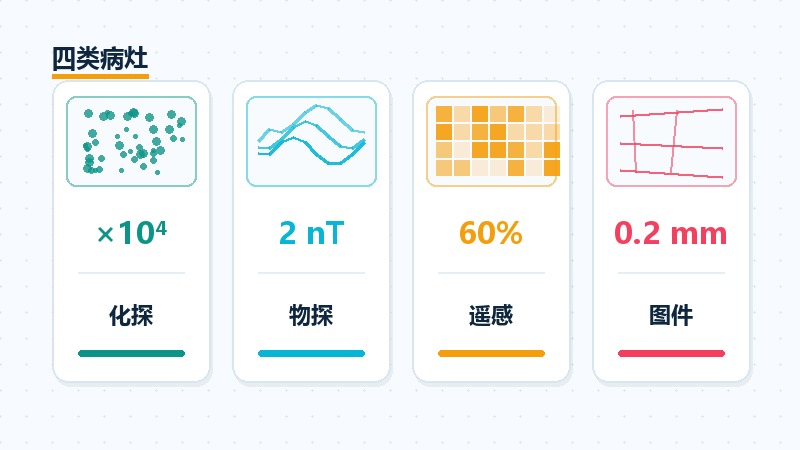
化探是表、物探是场、遥感是像元、地质图是线,四类数据的错法完全不同。先摸脾气,比急着跑模型省时间。
化探:单位不统一,同一个铜有三种写法
最常见的一幕,是把三个年度的土壤测量拼成一张表,铜这一列里既有 μg/g 也有 %,还有人把 ppm 写成 10⁻⁶。μg/g 和 ppm 是一回事,百分之一是它们的一万倍——有人用厘米报身高、有人用米报,直接求平均,这个数谁都不信。
检出限是第二个坑。低于检出限的样,有人记 0,有人记 -999,有人记 0.5 倍检出限;记 0 会把背景拉低,异常下限跟着往下走,图上凭空多出一片假异常。
判断标准很硬:先看有没有 unit 列和 lod 列。没有就翻送样单和测试报告;两样都找不到,整批退回,别一边猜一边建模。最常见的是用查找替换把“%”删掉——单位没了,数据也废了,废得悄无声息。
物探:基准与日变,仪器每天都在漂
磁力仪像一台体重秤:早晚都站上去 70 公斤,读数却漂了零点几。日变站就是每天校秤的那台标准秤,把漂移扣掉,不同日期测的数据才拼得到一起——别把秤的毛病记到地质体头上。
更麻烦的是跨年度、跨仪器拼接。两个测区并成一条线,基准不一致时接缝处会出现一条“台阶”,等值线突然错位,看着像断层,其实是仪器的事。
判断规则:拼接前先找重叠带,宽度 200–500 m 就够用;重叠段两套数据的系统偏差超过 2 倍均方差,就不能直接拼,要做基准平移,也就是调平。调平只允许常数或低阶多项式,别把局部高低点抹平——图好看了,异常也没了。
重力、电法还多一层:纬度、高程、布格改正都得做,高程基准不统一,改正量差出毫伽级,异常形态整个变样。
遥感:不做到地表反射率,跨景就没法比
遥感影像原始给的是 DN 值,是传感器记的电信号,不是反射率。辐射定标把它变成辐亮度,大气校正再去掉大气散射,才得到地表反射率——DN 值是“相机看到的亮度”,反射率是“地面本来的颜色”,不做这一步,同一片地在两景里颜色都不一样。
混合像元是第二个坑。30 m 的像元里可能六成植被、四成裸岩,光谱是两种地物调出来的颜色,像一个调色盘。蚀变提取靠特定波段的吸收特征,被植被盖住就没了,剩下都是噪声。
判断规则:植被覆盖度超过 60% 的图幅,别指望蚀变指数,退回目视解译;跨景拼接前做相对辐射归一化,找一块稳定地物(大片裸岩、清水水体)当参照,两景同名地物反射率差超过 5% 就得重新校正。常见错误是拿春季和秋季影像做变化检测,把物候变化当成蚀变变化。
地质图件:矢量化本身就是一次有损压缩
纸质图扫描再描线,误差是叠加的:扫描仪畸变、配准残差、描线手抖。1:5 万图上 1 mm 等于实地 50 m,手抖 0.2 mm,地上就是 10 m——图上一点点,地上一条街。
还有拓扑错误:断层线压在地质界线上没打断,面要素之间有缝隙或重叠,钻孔点位落在接边处对不上。单看一张图不明显,一进空间分析,缓冲、叠置、面积统计全跟着错。
判断规则:矢量化精度按图上 0.2 mm 控制,1:5 万图幅对应实地 10 m;面要素闭合率、悬挂点数量、面重叠面积三项逐项查,闭合率不到 100% 不许入库。常见错误是把扫描件直接当底图配准,扫描仪本身的畸变没纠正,整幅图带着系统性偏移。
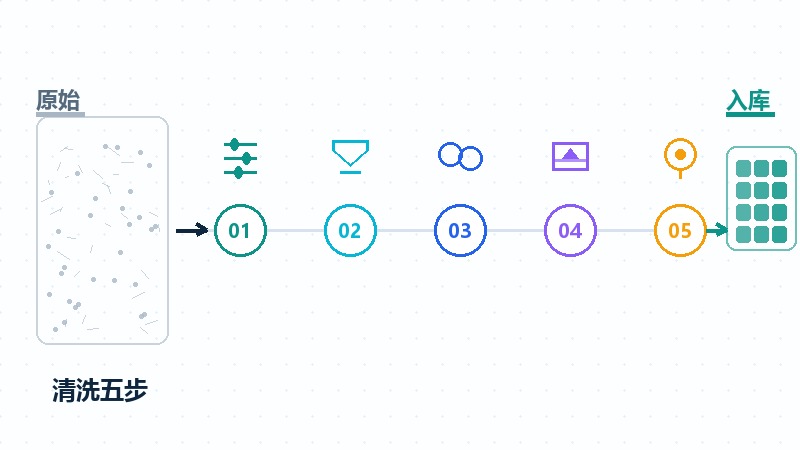
二、清洗五件事
地质数据清洗不是把表洗干净,是按规则把每一列变成可计算的口径。五件事按顺序做,错一步要返工。
第一件:单位统一
建一张单位映射表:元素、原始单位、换算因子、目标单位。铜统一到 μg/g,金统一到 ng/g,铁统一到 %。换算因子单独存一列,原始值不覆盖,为的是以后能倒查——换算是记账,不是涂改。
金的写法更乱:ng/g、ppb、g/t 混着用。ng/g 与 ppb 是一回事,g/t 与 μg/g 是一回事,两者差一千倍,报表上却常写成同一个“金品位”。
规则:同元素出现两种以上单位时,逐条按因子换算,换算后与同批数据的中位数比一比,偏离超过 3 倍中位数的逐条回查,多半是小数点错位或多打了一个零。
第二件:异常值判定
先别删。高值可能是矿化,也可能是录入错误。用稳健统计判:中位数 ± 3 倍 MAD(中位数绝对偏差),或箱线图的 1.5 倍四分位距——用中间那批数据当尺子,离得太远的就是可疑点。
见过一批数据,铜含量整列多了个零,3 倍 MAD 筛出 17 条,查下来是录入时小键盘的 0 按了两次。也见过相反的:把含矿层的高值当错误删了,图立刻变干净,矿也没了。
规则:超过 3 倍 MAD 的标 qa_flag = 2(可疑),不删;再翻该点的野外记录和二次分析结果,确认是矿化就保留并加注释,确认是错误就改回或剔除。常见错误是按 3σ 直接删点,把真正的矿致异常先删掉了。
第三件:重复样合并
同一点位采两次、或一个样分析两次,先算相对偏差:RD = |A − B| ÷ [(A + B) ÷ 2] × 100%。规则:≤ 20% 取均值;20%–40% 保留并备注;大于 40% 重采或剔除——两次差太多,说明这批样本身就不可靠。
合并后每个点位只留一条记录,两次原始值存在副表里,不要原地覆盖。常见错误是按点位编号去重,直接把第二条删了——丢的不是重复,是一次独立观测。
第四件:检出限替代
低于检出限的值不能当 0。常用两种替代:取 1/2 检出限,或取 1/√2 检出限(约 0.707 倍)。差别在方差:替代值越接近检出限,方差越大,后面做对数变换和插值越飘。这是常用做法,不是唯一标准,报告里要写清用的哪一种。
为什么两种?1/2 检出限偏保守,把低值往下压;1/√2 让数据取对数后更接近正态,插值更稳。选哪种看后面用什么统计方法,混用最糟糕。
规则:同一批数据只用一种替代方式;替代比例超过 30% 的元素不进模型,只做图面参考,因为一大半数据是补出来的。白话讲,一半以上的数是猜的,别指望算法从猜测里找出真相。
第五件:坐标系统一
全部转到 2000 国家大地坐标系,投影按项目区选高斯 3° 或 6° 分带。原始坐标单独存列,不覆盖——先把大家拉到同一把尺子上,再谈距离和密度。
规则:转换后至少选 5 个控制点核对,平面残差不超过 1 个像元(30 m 影像就是 30 m);跨带数据先换带再合并。跨带的问题在图幅接边处最常见:两套坐标拼在一起,接边处点位密度突然翻倍,其实是同一个点被算了两遍。
常见错误是拿地理坐标直接算面积——单位是度,一度经度在宁夏和海南差得远,算出来的数只能当笑话。
三、配准:不是把图层叠上去就算对齐
图层叠上去看着齐,不等于配准好了。三件事最容易翻车,翻车之后还看不出来。
重采样:连续场和分类数据不能用同一种
重采样是把一套网格的值搬到另一套网格上。双线性、三次卷积适合连续数据:物探场、DEM、反射率,值在空间上连续,插值才有意义。分类数据必须用最近邻:地质图、土地利用、蚀变分级,用双线性会把相邻两类混成一个不存在的第三类——把红和蓝平均成紫,而紫色在这张图上根本不存在。
还有个细节:NoData。双线性会把边缘的 NoData 当 0 一起平均,边界出现一圈暗边,看着像异常,其实是算法补的。
规则:栅格在元数据里写清 continuous 还是 categorical,脚本按类型选方法,别用默认值——默认通常是双线性,正好是分类数据最怕的那个;重采样前把 NoData 设成远离数据范围的值,别用 0。
分辨率不匹配:别把小像元当成高精度
30 m 的遥感影像和 500 m 网度的化探数据放一起,若按 30 m 网格采样,等于给每个像元编造一份化探信息——一个 500 m 的采样点被拆成约 278 个格子的“数据”。这是把小图放大当高清用,看着清楚,全是插出来的。
另一个方向也不行:把 30 m 数据块均值到 500 m,样本量一下少两个数量级,模型欠拟合,该做的是加密采样,不是换算法。
规则:分析网格取最粗数据的分辨率,或把细数据做块均值降到粗网格,绝不上采样细数据去凑网格。真要在同一网格建模,就在 500 m 网格上算统计量——均值、最大值、标准差、异常点数——当成像元属性。这样一条记录对应一个采样点,样本量是多少就是多少,不虚。
投影转换:残差藏在面积里
换带、换基准都会引入残差。常用坐标系之间转换,参数不对,偏差能到几十米,图上看着只是“稍微偏了一点”——距离、面积、密度全错,而且错得整齐,反而不容易发现。
规则:转换用不少于 5 个公共控制点求解参数,残差均方根控制在 0.5 个像元以内;算面积、算密度必须用等面积投影,不要拿经纬度直接算;转换参数、软件版本、操作人写进元数据。常见错误是拿一张图“目视对齐”就当成配准完成——中间对齐了,四角往往还偏着,而异常区常常就在边上。
四、样本化:正样本怎么定,负样本怎么选
到这一步,数据干净了、对齐了,决定模型上限的是样本。样本错了,前面全白做。
正样本:已知矿点不等于正样本
数据库里 200 个矿点全当正样本,是智能找矿最常见的错误。矿点是“有过工作的位置”,不是“有矿的位置”:有的是民采老硐,有的是矿化点,有的只是拣块样高值,还有的坐标是图上量的,误差几百米——把“有人去过”当成“有矿”,等于拿乡政府地址当金矿位置。
四条判断标准,缺一条就降级:
一,有工程控制。槽探、钻孔见矿才算,只有地表拣块样的最多算矿化点。
二,坐标可信。GPS 实测优于 5 m,或图上点位精度高于 0.2 mm(1:5 万图幅约 10 m)。
三,同一成矿类型、同一地质单元。斑岩型和蚀变岩型混在一个训练集里,模型学的是两套规律的平均,结果谁都不像。
四,矿体尺度与像元尺度可比。矿体长 50 m、像元 30 m,勉强能识别;矿体 10 m、像元 250 m,怎么学都学不出来,这不是算法问题,是分辨率不够。
不满足的,单独建一张“疑似”表,打标签 unlabeled,不进训练集。
负样本:随机撒点是致命的
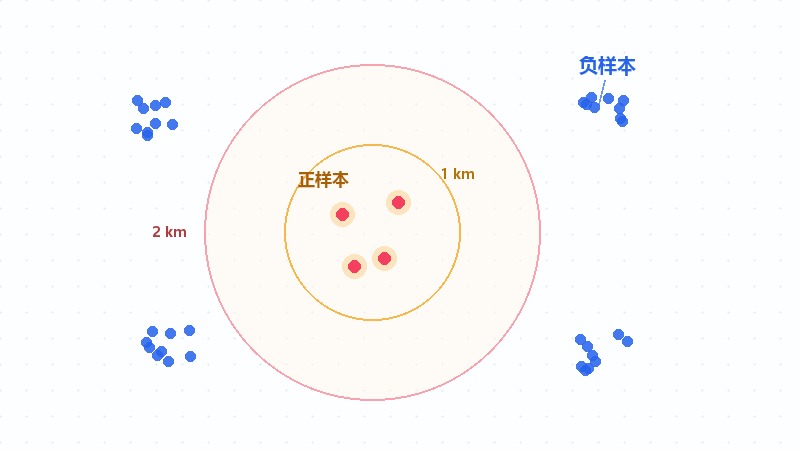
负样本决定判别边界,比正样本更难做。随机撒点有三个致命错误:撒在已知矿化带里,等于告诉模型“这里有矿也算无矿”;撒在没有数据的区域(城镇、水体、冰川),模型学的是“没测过”;正负失衡,1:50 会让模型只学会说“无矿”,准确率还挺高。
做法:先按已知矿点做缓冲,半径取异常半径的 3 倍,或直接取 2 km,哪个大用哪个;缓冲带以内不选负样本;带外按地质单元分层随机抽,保证每个单元都有反例;负样本要能说清“为什么确信无矿”——有踏勘记录、有物化探低值、有工程验证,三者有一即可。正负比例控制在 1:2 到 1:5。
还有一种情况必须单独处理:落在未勘查区的点,标 unlabeled,不当负样本。没查过不等于没有,把它当反例,就是在教模型认错。
样本集划分:随机切分是数据泄漏
按 7:2:1 随机切成训练、验证、测试,最省事也最容易出错。相邻样本点在空间上高度相关,随机切分会把同一矿点的邻近点同时放进训练集和测试集,模型等于提前看过答案——把答案抄在草稿纸上带进考场,分数当然好看。
做法:按空间分块切分,研究区划成若干网格块,整块进训练或整块进测试;块大小取样本自相关距离的 1.5–2 倍,一般 5–10 km;同一矿点缓冲区内的样本整组进同一集合。
判断标准:换成分块切分后,测试精度比随机切分低 10–20 个百分点是正常现象;如果两者几乎一样,先怀疑切分漏了。分块之后还要查一件事:同一批送样、同一次分析的数据是否落在同一块里,跨块混用等于变相泄漏。
五、一份可复用的数据字典模板
找矿大数据的价值不在数据量,在每一条记录能不能被别人复算。字段设计的目标就是这个:换个人拿到表,知道每个数从哪来、怎么算的、能不能用。
下面这份模板改改就能用,示例数据非真实项目,只说明填法。
表1 智能找矿数据字典的字段设计
| 字段名 | 类型 | 含义(白话) | 示例 | 必填 |
|---|---|---|---|---|
| sample_id | 文本 | 样品或点位的唯一编号,全表不重复 | S-000123 | 是 |
| src_type | 文本 | 数据来源:化探、物探、遥感、图件 | 化探 | 是 |
| x, y | 双精度 | 投影坐标,单位米,同一工程只用一个投影 | 3645210, 4258730 | 是 |
| lon, lat | 双精度 | 经纬度,留一份便于对外交流 | 106.27, 38.47 | 否 |
| crs | 文本 | 坐标系与投影带,写全称不写简称 | CGCS2000_3_Degree_GK_CM_105E | 是 |
| elem | 文本 | 元素或测量项代码,统一大小写 | Cu | 是 |
| value | 双精度 | 测量值,换算后的值 | 32.5 | 是 |
| unit | 文本 | 单位,换算后的单位 | μg/g | 是 |
| value_raw | 双精度 | 原始值,不参与计算,只备查 | 0.0032 | 是 |
| unit_raw | 文本 | 原始单位 | % | 是 |
| lod | 双精度 | 检出限,同单位 | 1.0 | 是 |
| flag_lod | 整数 | 0 实测,1 低于检出限已替代 | 1 | 是 |
| rd | 双精度 | 重复样相对偏差,百分比 | 8.4 | 否 |
| qa_flag | 整数 | 0 正常,2 可疑,3 剔除 | 0 | 是 |
| date | 日期 | 采样或观测日期,精确到日 | 2024-05-12 | 是 |
| sampleset | 文本 | train、valid、test、unlabeled 四选一 | train | 是 |
字段命名只认两条:小写下划线、见名知义。value 与 value_raw、unit 与 unit_raw 成对出现,比拼音首字母缩写强得多——三个月后自己都认不出来。
版本管理别靠文件名。单独建一张元数据表,记录每版的字段变更、换算因子调整、样本增删,谁改的、什么时候改的、为什么改——数据字典不是写给今天的人看的,是写给两年后接手的人看的。
有两组字段最容易被省掉:value_raw 与 unit_raw,还有 sampleset。前者省掉,一年后没人说得清数据怎么来的;后者省掉,训练集和验证集混着用,精度虚高,一上新区就现原形。
六、一句话结论
如果只能记一句话:先建底座,再谈模型。数据洗干净、配准准、样本分得清,模型普通一点也能出靶区;反过来,模型再花哨,也只是把错误算得更快、更有说服力。