遥感蚀变信息提取从来不是专家盯着影像找色块。从比值法进入实用的那天起,这件事就是波段运算,机器一直在算,人只负责选波段、定阈值、看结果。把"AI 比人眼看得多"当成立论,后面的判断会全错。真正成立的比较只有一句:学习型方法对规则型方法。
一、先纠正一个误解:传统方法从来不是人眼看图
传统蚀变提取是波段运算,不是判读。对比的基线搞错,谈深度学习就没有意义。
很多人对这项工作的想象是这样:专家坐在屏幕前,在一张假彩色影像上找那种偏红、偏紫、偏黄的色块,凭经验圈出来。这个画面确实存在过,但那是在没有多光谱数据、只有航片和胶片的年代。
从比值法进入生产流程起,这件事的性质就变了。两个波段相除、若干个波段线性组合、一条光谱曲线比对,都是确定性的数学过程。同一景影像、同一组参数,谁跑出来的结果都一样,不依赖当天状态,也不依赖经验深浅。
机器一直在算。人的位置往后挪了两步:一是决定用哪几个波段、阈值卡在哪个数上,二是在结果图上判读与复核。前者是设规则,后者是纠错。
主成分变换,白话讲就是把多个波段携带的信息重新组合成几个互不相关的新方向,其中某个新方向上"这个波段亮、那个波段暗"的组合特征,恰好对应蚀变矿物的光谱行为。
光谱角匹配更纯粹。它把像元光谱与参考光谱都当作一支箭头,只比方向、不比长短,所以对亮度变化不敏感。
这三样东西共同的属性是:规则由人写死,机器只管执行。既然如此,"机器比人看得多"这个说法就站不住了,因为机器从头到尾都在看,从来没有靠人眼提取过。
真正成立的比较是:学习型方法与规则型方法。前者从样本里把判据学出来,后者由人把判据写在公式里。这一句替换很关键,它决定了后面所有的判断。
判断一份报告值不值得细看,先看它把基线写成什么。基线写"人工解译"的,结论基本都是自我印证;基线写"比值法、主成分、光谱角,同一景影像、同一验证点集"的,那些数字才有讨论价值。
补一句边界:传统流程里人的判断并没有消失,只是集中在两个关口——开头定规则,结尾挑结果。这两个关口做得好不好,直接决定后面模型的输入质量。
二、传统三件套的原理与局限
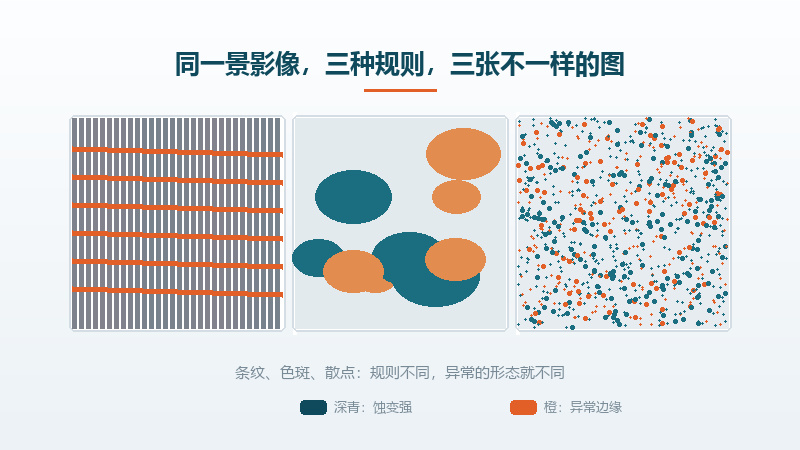
三件套各自有一段好用的区间,短板却是同一个:混合像元与复杂背景。
波段比值法最直接。蚀变矿物在特征吸收波段暗、在相邻反射波段亮,把这两个波段相除,一暗一亮就被除成了高值。铁染类常用可见光近红外的一段组合,泥化类用羟基吸收带附近的组合,行业里各有习惯配比。
白话讲,它就是把"蚀变矿物在这两个波段一暗一亮"的差别,用除法放大成一张灰度图。亮的地方,就是比值高、疑似蚀变强的地方。
它的优点是简单、快、每一步都能倒推。评审问"这个高值怎么来的",你可以当场把公式写出来。
局限也很明确。地形阴影、太阳高度角、土壤湿度都会改写比值。同一片蚀变岩,阴坡和阳坡的比值能差出一截;雨后和旱季的影像,阈值也不通用。
一个能落地的做法:同一研究区跨两景以上影像时,比值阈值必须分景重定,用同一批地面控制点回标。直接把上一景的阈值搬过来,虚警率常翻一倍(常用经验值,非唯一标准)。
分割阈值的定法也有讲究。按均值加两倍标准差切一刀,是最常见的做法,简单但假设了背景服从正态分布;实际影像常有长尾,更好的做法是先看直方图,在肩部拐点处切,再叠加面积下限剔除零星斑块。
主成分分析(Crosta 法)是行业主力。它对多波段做正交变换,再从中挑出载荷符号组合符合蚀变特征的那一个分量。选分量的依据是"某波段载荷为正、某波段载荷为负"这种特定组合,而不是看哪个分量好看。
白话讲,它把多个波段压成几个互不重叠的新方向,某个方向上恰好保留了蚀变的光谱反差,其余方向装的是地形、植被、亮度这些干扰。
分量怎么挑,行业里有固定的查表式做法:先看各波段的载荷符号组合,铁染类找"某波段载荷与其余波段反号"的分量,泥化类找另一组。挑出来的分量再做一次拉伸与密度分割,异常才浮得出来。
问题在于,选错分量就是全废。云、植被、水体对变换结果敏感,一条河、一片云影都可能拉出一个假分量。分量编号逐景变化,上一景的第二分量是蚀变,这一景可能挪到第四分量。
做批量处理时,这一步最费时间。一个县十几景影像,逐景挑分量、逐景定分割阈值,人工成本往往比跑算法高得多,这也是很多项目最后只剩首尾两景的原因。
有个简单的自查:分量编号变了,异常位置却一点没变,多半不是选对了分量,而是选到了一个背景分量。
光谱角匹配(SAM)的原理是把像元光谱和参考光谱当向量,比夹角不比长度。它对光照不均的山区友好,阴影区的像元长度被压低,方向却不变,夹角依然能算。
它依赖光谱库。库里的端元来自实验室或别处的实测,与本地地物的实际光谱常有差异,拿外来端元直接套,夹角会系统性偏移。混合像元下夹角还会失真,几种地物叠在一起,合成出来的方向谁都不像。
表2 三种传统蚀变提取方法的原理与失效场景
| 方法 | 原理 | 适用 | 失效场景 |
|---|---|---|---|
| 波段比值法 | 特征吸收与反射波段相除,放大蚀变差异 | 铁染、泥化快速出图 | 地形阴影、土壤湿度变化大的区域 |
| 主成分分析 | 多波段正交变换,取载荷特征符合蚀变的分量 | 大面积区域初筛 | 分量选错即全废,云、植被干扰敏感 |
| 光谱角匹配 | 像元光谱与参考光谱比夹角,不看亮度 | 光照不均的山区 | 混合像元下夹角失真,依赖光谱库 |
三件套的共同短板是混合像元与复杂背景。这也正是深度学习唯一真正的机会窗口,其余场合它并不占优。
三、深度学习的真实增益只有三点
深度学习不是"精度更高",而是在三类具体困难上多给出了一点信息。
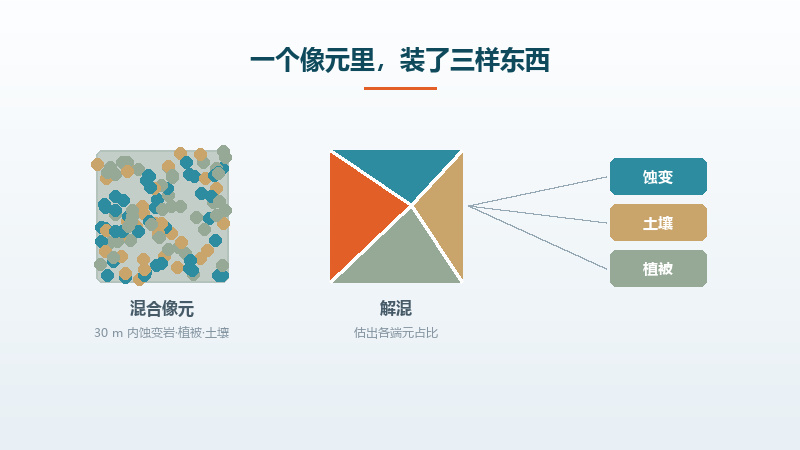
第一点是混合像元解混。一个 30 m 像元里,可能同时落着蚀变岩、稀疏植被和坡积土。传统方法拿到的是这些地物的加权平均光谱,蚀变信号被植被和土壤稀释,比值随之被拉平。
学习型方法可以从混合光谱里反推各端元的贡献比例。白话讲,一杯兑了水的果汁,传统方法只能告诉你"整体偏淡",学习型方法试着把水和果汁各自估出来,再看果汁本身浓不浓。
第二点是弱信息增强。蚀变弱、面积小、与围岩反差低的异常,在固定阈值下很容易被背景噪声吞掉。卷积类模型对局部纹理和微弱响应更敏感,能把"整体偏亮一点"的区域挑出来。
第三点是复杂背景下的干扰抑制。高植被覆盖区、荒漠戈壁、雪线附近,传统阈值法几乎失效,因为干扰的强度已经盖过蚀变。有足量标注时,模型能学会忽略植被纹理、保留蚀变响应。
这三点增益的位置值得说清:它们都发生在像元内部和像元邻域,改的是"怎么从一段光谱、一小片窗口里读信息",不改地质判断本身。模型不知道什么是蚀变带,它只知道被你标成蚀变的那类像元长什么样。
工程上也有一点实际差别。传统方法换一景影像要重调参数,学习型方法换一景影像通常只需重新归一化输入,参数不用动。影像多、更新频繁的项目,这一项省下的人力比精度提升更值钱。
这三点的共同前提只有一个:足量且可靠的标注。没有标注,深度学习什么也不是。它不是自己长出了地质知识,而是从你给的样本里把判据抄了一遍。
必须说清另一半:除此之外的所谓提升,多数来自调参与后处理。换一组阈值、加一遍滤波、人工修边、剔除零星斑块,这些动作在传统流程里同样能做,效果也差不多。
一个直接的判据:验证区的野外验证点少于 100 个时,不要宣称模型的泛化能力,那个数字没有统计意义。
四、它带来三个新问题
深度学习没有消除误差,只是把误差换了一种形式:从"参数选错"变成"样本不够"。
第一个问题是样本从哪来。蚀变样本标注极贵,每个点都要能落到野外。一个研究区能拿出的可靠标注,常常只有几十到几百个像元级样本,远少于常规图像任务动辄上万的量级。
标注还带主观性。同一条蚀变带,两个人圈出来的边界能差出十几米,模型学到的是谁的边界,取决于谁标注的。
样本分布也很难平衡。一个研究区里蚀变像元通常只占千分之几到百分之几,正负样本天然失衡,模型很容易学会"全判非蚀变"这条捷径,损失曲线看着很漂亮,实际什么都圈不出来。
第二个问题是可解释性。评审专家问"为什么这块判为蚀变异常",模型答不上来。传统方法至少能回一句"这个分量载荷符合绢云母特征",把依据摆到桌面上。
SHAP 值、类激活图能缓解,能标出"模型主要看了哪几个波段、哪一片区域",但在正式地质评审场合,这类证据往往不够。评审要的是地质依据,不是注意力热图。
第三个问题是跨区迁移。A 区训练的模型搬到 B 区,气候、岩性组合、传感器都变了,掉点会很严重。每换一个区就要重新标注,成本优势随之消失。
一个明确的阈值:跨区使用同一模型时,若验证区检出率下降超过 30%,必须重新训练,不能直接套用。
这个方法在这里不适用:研究区没有历史验证点、也没有能力组织野外复核时,深度学习提取出来的图只能当参考底图,不能进报告结论。它没法自证,评审也不会替它作证。
五、对比实验怎么做才公平
公平对比的前提是锁死变量。锁不住变量的"提升",多半是换了数据或换了口径。
要锁死四样东西:同一景影像、同一套预处理流程、同一个验证点集、同一套评价标准。四样里缺一样,两个方法的差距就无法归因。
评价指标用检出率与虚警率两个。检出率是已知蚀变点里被成功检出的比例,虚警率是判为异常但野外没有蚀变的比例。
不要只报总体精度。总体精度会被大量"非蚀变"像元拉高,一个把所有像元都判成非蚀变的模型,总体精度也能到 95%。这个数字在这类极不平衡的任务上没有意义。
虚警率比检出率更能说明问题。野外验证的成本主要花在跑空点上,一个虚警点就是一趟车、一天工、一份记录表。
表1 传统方法与深度学习五维对照
| 方法 | 检出率 | 虚警率 | 标注需求 | 可解释性 |
|---|---|---|---|---|
| 波段比值法 | 62% | 38% | 无 | 高 |
| 主成分分析(Crosta) | 71% | 31% | 无 | 中高 |
| 光谱角匹配 | 68% | 27% | 需光谱库 | 中 |
| 深度学习(U-Net 类) | 84% | 22% | 不少于 100 个验证点 | 低 |
示例数据,非真实项目。
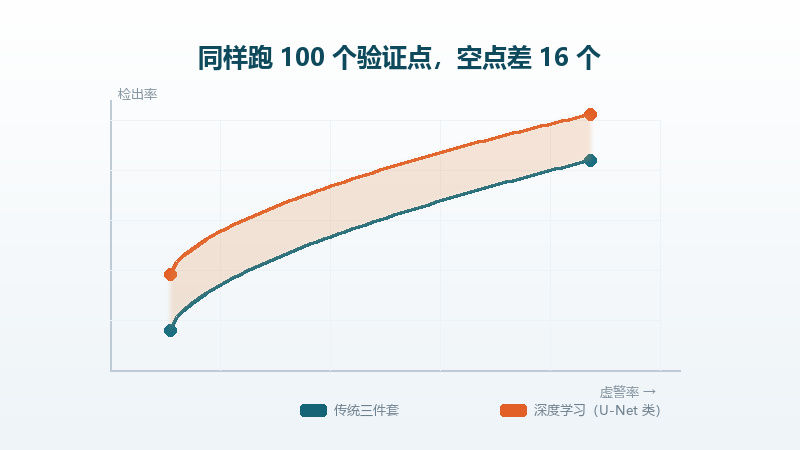
把这张表读透,比记住 84% 这个数更有用。检出率从 62% 抬到 84%,代价是"不少于 100 个验证点"和可解释性从高掉到低。虚警率从 38% 降到 22%,意味着同样跑 100 个点,空点从 38 个降到 22 个。
省下的是野外工作量,不是判决权。16 个空点的差别,对一支队伍就是一个多月的野外时间。
还有一个容易被忽略的口径:验证点必须独立于训练样本。用训练过的点去验证,任何方法都能报出漂亮数字,那是自测,不是验证。
验证点的空间分布也要讲究。全挤在一两条蚀变带上,得出的检出率只对那两条带有效。合理的布法是分层抽:已知带内、带外推测区、无异常背景区各抽一批,三类的数字分开报。
报告里至少给三个数:带内检出率、推测区检出率、背景虚警率。只给总检出率,等于把最难的那部分藏起来了。
预算有限时的判断很直接:一个项目若野外验证预算只够 30 个点,把预算全投在深度学习上是浪费;同样的钱用来加密传统方法的验证点,检出率的提升更实在。
六、实操建议
选方法的依据不是新不新,是有没有标注、要不要解释、后面有没有人复核。
用传统法的情况很清楚:研究区首次开展、没有任何标注、要快速出图、成果必须过评审且需要可解释、影像质量一般。这几种情况叠加,比值法加主成分的组合仍然是最稳的选择。
上学习型方法也有明确的入口:已有一定野外验证点(超过 100 个)、植被或荒漠覆盖导致传统法失效、面积大且需要批量处理、项目组有后续复核能力。
排期上要留足标注的时间。按经验,标注工时约占整条学习型路线的五成到六成,训练与调参只占两成,剩下的是验证与出图;把标注排在最后,项目多半会卡在交付前一周。
两者结合是最推荐的路径:传统法出初稿,野外抽查,用抽查结果做标注,学习型方法在此基础上优化,最后再复核一遍。
这条路径成本最低,也最容易被评审接受。因为它的每一步都有野外证据兜底,模型只是把人工圈定的边界推得更细,而不是凭空多出一片异常。
交付物也要跟着分两套。传统法那一套交对比值图、主成分分量图、阈值说明;学习型那一套交样本清单、训练集与验证集划分、混淆矩阵、模型参数与权重版本。两套一起归档,三年后有人复核,还能复现。
一个硬阈值:野外验证点少于 50 个时,不要做深度学习提取,投入产出不划算。
这个方法在这里不适用:成果只用于内部初步筛查、不进入正式报告时,任何方法的精度都不值得投入,先出一张能看的图,比选方法重要。
粗口径的成本参考:传统三件套单景处理与成图,两三天可出;深度学习路线从标注到可交付,通常要三到五周,其中标注占一半以上工时【作者测算:按两人配合、单景 30 m 多光谱计,非官方数据】。
七、一句话结论
方法为地质服务,不为精度指标服务。
传统法给你一张能解释的图,学习型方法给你一张更细的图,但两张图都必须下野外。
找矿大数据决定了蚀变提取能不能比,校正和配准没做好,任何方法都在噪声上做文章;随机森林面对的是同一道选择题——规则与学习,谁更适合眼前这批数据。
真正该问的不是"哪个方法更先进",是"这批数据、这笔预算、这个评审口径,容得下哪种方法"。