随机森林和 XGBoost 是化探异常圈定里出现频率最高的两个模型。我的核心判断只有一句:模型不是越新越好。手上数据长什么样,就该用什么模型;把四十个正样本喂给 XGBoost,图会比随机森林好看,但那是过拟合的好看,落到布孔上不认账。
这十几年里我既写过脚本,也评过别人的报告,见过的最常见的错,不是模型选错,而是标签没定清楚就开始比精度。术语第一次出现都会给一句白话,不必懂代码也能看完。
一、两者的地基差异
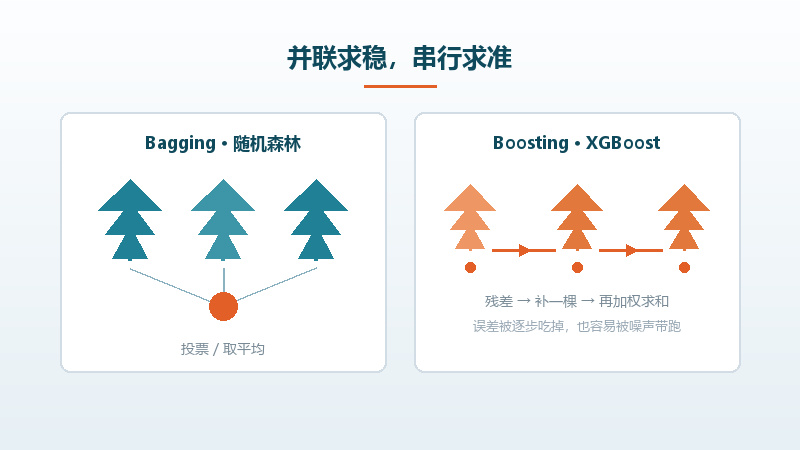
随机森林属于 Bagging。白话讲:同时种很多棵树,每棵树只看一部分样本、一部分特征,最终投票或者取平均。单棵树容易犯错,但很多棵树的错误互相抵消,所以结果稳。它靠“多树平均”降低方差,方差可以理解成“换个数据集结果晃不晃”。
XGBoost 属于 Boosting。白话讲:先种一棵树,看它错在哪儿,再种一棵专门补这个错,一棵接一棵往下补,再把所有的树按权重加起来。它靠“逐步纠错”降低偏差,偏差可以理解成“离真实答案差多远”。精度潜力比 Bagging 高,代价是最容易记住噪声。
这个差别直接决定使用场景。Bagging 是并联的,树与树互不知情,某一片区域的噪声很难被所有树同时学到;Boosting 是串联的,后一棵树盯着前一棵的残差猛补,样本少的时候,它会把“某个采样点碰巧见了矿”这种偶然事件当成规律反复强化。你看到的训练集精度 0.95、验证集掉到 0.6,多半就是这么来的。
XGBoost 还有一层隐形成本:参数多。学习率、树深、叶子最小权重、行采样、列采样、正则系数,每一个都能让结果变一个样。调参本身没错,错在很多人拿全量数据反复试,试到指标满意为止——这等于用测试集选模型,指标必然虚高。随机森林的参数少得多,默认值通常就能用,这也是它在工程上“便宜”的原因。
顺带说 SVM。白话讲:在高维空间里找一个最宽的“分界面”,把正负样本尽量分开。它适合特征多、样本少的情形,理论上对小样本友好;但三个问题让它在这类项目里不好用——对特征缩放极其敏感(化探各元素量纲差几个数量级,不标准化直接崩),概率输出要额外校准,样本上到上千以后训练慢。更关键的是它不给特征重要性,评审问“为什么这片红”,答不上来。小样本、特征已标准化、只想要一个分类结果时,SVM 可以拿出来当对照,别当主力。
一句话记这三种:随机森林靠平均求稳,XGBoost 靠纠错求准,SVM 靠间隔求分。稳和准是两条路,走哪条取决于你的数据撑不撑得住“准”。
二、地质数据的三道坎
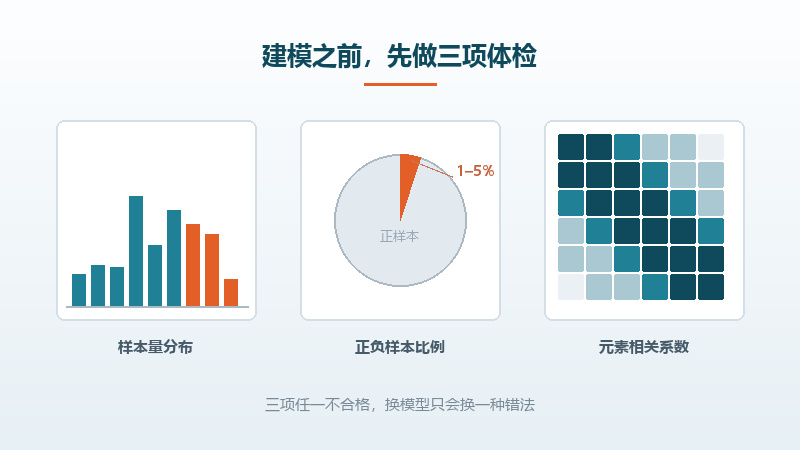
第一道坎是样本少。一个矿带的正样本,几十个到一百多个是常态,跨省汇总也就几百。树的参数量是按“数据管够”设计的,样本一少,每棵树分到的正样本可能只有个位数,模型实际是在背样本,不是在学规律。这时候交叉验证也帮不了你:如果每折里正样本只有五六个,指标抖动比模型差异还大,AUC 差 0.05 完全可能是抽样造成的。
第二道坎是正负样本不平衡。化探工区动辄几千平方公里,真正见矿的点只占百分之一到五,负样本压倒性多。AUC 在这种数据上会虚高——白话讲,AUC 是“随机拿一个正样本和一个负样本,模型把正样本排在前面的概率”;负样本越多、越容易区分,AUC 越好看,可它不告诉你“排在最前面的那一小片准不准”。做靶区圈定的人真正关心的是前 10% 面积里命中多少,这个指标得单独算,叫召回率。
第三道坎是共线性。三十九种元素加上派生比值,元素之间相关系数 0.7 以上很常见,铜和钼、铅和锌经常一起动。树模型对共线性不敏感,分裂时随便挑一个用就行,精度不受影响;但特征重要性会被摊薄——同一份信息分给两个变量,两个看起来都不重要。你要是拿这张重要性表去写报告,说“铜不重要”,评审一眼就能挑出毛病。SHAP 也一样,白话讲 SHAP 是“把这个预测拆开,看每个特征各推了多少”,共线性下它会把贡献分给相关的几个特征,读起来像在说胡话。
三道坎叠在一起,结论很清楚:模型能不能用,先看数据够不够格;不够格的时候,换模型只是换一种错法。
还有一件事常被当成技术细节其实是数据问题:检出限。化探样品里大量元素低于检出限,表格里要么填 0,要么填一半检出限,要么干脆空着。三种处理方式会让同一份数据生成三个不同的模型,特征重要性排序也跟着变。填 0 最省事,也最容易把“低值区”教成“无矿区”;填半检出限是行业惯例,但必须在报告里写明;直接删列则会丢掉可能关键的指示元素。这几条规则在 找矿大数据 的清洗环节就该定死,而不是等建模时再回头改。
三、对比实验该怎么设计
要比两个模型,四个“同”必须做到:同一份数据、同一套特征、同一个切分、同一套评价口径。差一样,比较就没意义。很多报告里“XGBoost 比随机森林高 3 个点”,一问切分方式不一样,这个结论直接作废。
具体做法:固定随机种子;特征表一次做好,两个模型共用;切分用空间分块(下一节细说),不要用随机切分;随机森林用接近默认的参数(500 棵树)当基线;XGBoost 允许调参,但调参必须在训练折内部完成,用嵌套交叉验证,不能拿测试折反复试。
指标至少三个:AUC 看整体排序能力,召回率@前 10% 面积看业务效果,特征重要性稳定性看结论能不能写进报告。稳定性用不同折之间重要性排序的秩相关来衡量,秩相关就是“两次排序像不像”,1 是完全一致,0 是毫无关系。
实验记录比结果更值得留。至少写清五样:数据版本(哪一版清洗结果)、特征清单(一共多少个、怎么派生)、切分文件(哪些点属于哪一折,能复现)、参数与随机种子、运行时间。评审真要较真,翻的就是这几页;没有这几页,“高 3 个点”只是个说法。
还有个小坑:别在两张不同色标的图上比模型。同一个工区,两个模型出图时如果一版自动分了五级、另一版分了七级,人眼看上去“红得多”的那张会显得更好,其实跟精度没关系。统一分级方案再比,或者干脆只比表,不比图。
下面这张表是示例数据,非真实项目,只用来演示怎么读结果:
表1 随机森林、XGBoost、SVM 在同一份化探数据上的对比(示例数据,非真实项目)
| 模型 | AUC | 召回率@前 10% 面积 | 特征重要性稳定性 | 训练耗时 |
|---|---|---|---|---|
| 随机森林(500 棵,默认参数) | 0.82 | 0.61 | 0.86 | 分钟级 |
| XGBoost(调参后) | 0.85 | 0.58 | 0.62 | 十分钟级 |
| SVM(RBF 核,特征已标准化) | 0.79 | 0.55 | 不提供 | 分钟级 |
这张表最值得看的不是 AUC 那一列,而是后两列的反向关系:XGBoost 的整体排序更好,可前 10% 面积里的命中反而低,特征重要性还从 0.86 掉到 0.62。翻译成人话——它把分数抬上去了,抬在了你不太需要的地方;而且换个折,最重要的特征就换人,这种结论没法写进报告。
四、什么时候选随机森林
我把门槛写成一句可以直接执行的话:正样本少于 100 个,直接用随机森林,别折腾 XGBoost。
这个数量级下,XGBoost 调参的收益基本被过拟合吃掉,而调参过程还引入额外的选择偏差。随机森林的默认参数在几十到一百个正样本上表现稳定,出图快,评审时还能拿特征重要性逐条解释——虽然会被共线性摊薄,但方向大体是对的,能撑住“为什么这片红”的追问。
具体适用情形我列几条,对上三条以上就别犹豫:正样本不到 100;特征是二三十到七八十个常规图层(化探、重磁、遥感蚀变信息提取、断裂缓冲、地层距离);任务目标是“圈出可疑区”而不是精确排序;团队里没人专职调参;一周内要出图进报告;数据质量参差,有缺失值、有异常高值、年代不一致。
还有一个常被忽略的点:随机森林天生适合做“筛子”。先用它把明显不可能的区域筛掉,再对剩下的小区域做精细分析,这套流程在项目上比一次性追高精度实用得多。参数上也别乱调,树数五百上下就够,叶子最小样本量设小一点(三到五),让树能分出细节;真要限深度,代价是模型退化成一个大号决策树,反而不稳。
随机森林也会过拟合,只是过得比 Boosting 温和。典型症状是训练集 AUC 接近 1 而验证集不到 0.75,这时候先怀疑特征里有泄漏,而不是急着加树。
五、什么时候选 XGBoost
反过来,XGBoost 该上的时候也很明确:正样本三百个以上,特征工程做足,并且确实需要精确排序。
三百个以上不是拍脑袋——跨矿带汇总、多矿种合并、或者把矿化显示当弱标签扩样本之后,才可能到这个量级。到了这个量级,Boosting 降偏差的优势才显出意义:它能捕捉特征之间的组合效应,比如“某层位”加“距断裂特定距离”这种单看都不突出的组合,树模型串起来才抓得住。
适用情形:要在几十个候选区里排出前五个布孔,排序质量直接影响钱怎么花;愿意做嵌套交叉验证和 SHAP 解释,能说清每个靶区的分是怎么来的;有算力,也接受调参要花几天;数据里存在明显的非线性交互,而且你确信这些交互在地质上讲得通。
这里有个分寸要说清:XGBoost 高出来的那两三个点,只有在“决定先打哪个孔”的时候才值钱。如果项目只是要出一张区域异常图交给上级,多这两三个点没人看得出来,反而多了一堆解释不清的参数。
真要用,参数上有一条经验:小样本场景把复杂度往下压——树深三到四层,叶子最小权重调高,学习率降到 0.05 以下,配合早停,一次只加几十棵树。这样做的精度未必比默认参数高,但方差小得多,换折之后结果不会大跳。反过来,树深放到十层、学习率 0.3、不限叶子样本,训练集能刷到 0.99,验证集惨不忍睹。
六、什么时候都不该用
有三种情况,两个模型都不该用,硬上就是给自己埋雷。
正样本少于 50 个。这个量级下任何树模型都在记样本,交叉验证的五折里,每折可能只有十个正样本,指标没有统计意义。此时更诚实的做法是回到证据权重加地质规则:把“必须赋矿层位”“距断裂多少米内”“某元素组合达标”写成硬条件,人工圈定,报告里把依据列清楚。模型不是必需品,说不清的时候不上模型。
标签不可靠。正样本如果来自“见矿点”而不是“验证过的靶区”,或者把矿化显示、民采痕迹混进了正样本,标签本身就是错的。标签错了,模型越强越危险——它会把错误的标签学得更像,然后给你一张自信满满的热力图。我见过把老采坑当正样本的项目,圈出来的靶区全在老采坑周边,那不是预测,那是考古。
空间自相关没处理。化探采样点间隔常常是几百米到几公里,相邻点的元素含量高度相关。随机切分把相邻点分到训练集和测试集,模型等于提前看过答案,精度虚高,虚高幅度通常能到十个点上下(这是经验判断,不是我测出来的数)。处理不了自相关,就别谈精度。
另外提一句特征泄漏:拿人工圈定的异常边界当输入特征、拿后期补做的测井解释当早期特征,都是把答案提前喂给模型。这种错误在报告里最隐蔽,也最致命。
再补一类更常见的误用:跨区直接套模型。在一个矿区训练好的模型,搬到三百公里外另一个成矿带,特征分布全变了,精度掉一半算正常。想跨区用,先做特征分布对比,把不重合的特征剔掉,或者只迁移“空间关系类”特征(距断裂距离、层位距离这类),别把绝对含量搬过去。
七、验证方式比模型更重要
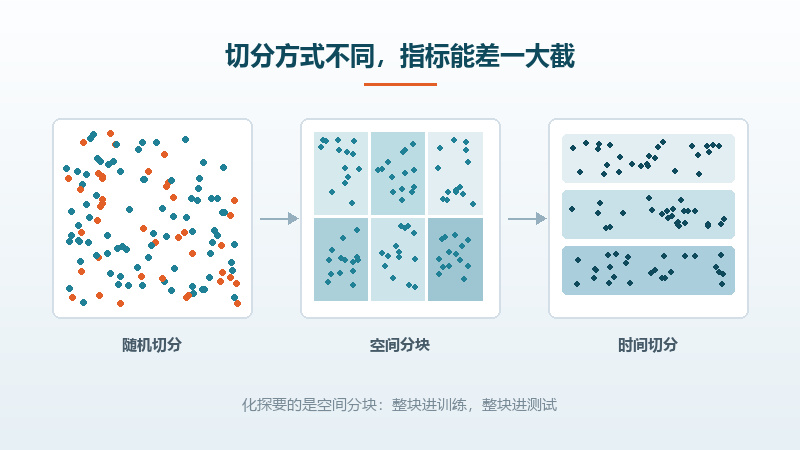
同一份数据、同一个模型,换一种切分方式,指标能差出一大截,差距往往比换模型还大。所以顺序应该是:先定切分,再谈模型。
随机切分是最常见也最错的做法。它假设样本互相独立,可地质样点根本不独立:相邻点的元素含量、地层、构造几乎一样,模型在训练集里见过了,测试集自然答得对。结果是交叉验证 AUC 0.9,换一个新区块做实际预测掉到 0.6。
空间分块切分才是地质数据该用的方式。做法是按构造单元、矿带或者规则网格把工区切成若干块,整块进训练或者整块进测试,绝不让相邻点跨在两边。块的大小不能拍脑袋,要大于自相关尺度——可以用半变异函数或者莫兰指数估一下,白话讲,莫兰指数就是衡量“邻近的点有多像”的指标。块太小,等于没分;块太大,测试样本又不够,一般取五到十块比较现实。
时间切分解决的是另一类问题:模型能不能预测未来。按勘查年度切,用早年数据训练、近年数据测试,模拟真实使用场景。这种方法在滚动更新的项目里很有价值,但要求数据本身有时间维度,很多老工区凑不出来。
三种切分对应三种问题:随机切分回答“能不能拟合”,空间分块回答“能不能推广到未知区”,时间切分回答“能不能预测下一步”。化探异常圈定要的是第二个答案,所以必须用空间分块。这一条比模型选择重要得多,也是评审最容易被问住的地方。
落地时还有两个细节。一是分块要跟地质单元对齐,能按矿带或构造单元切就别硬套规则网格,否则测试块里一半是已知矿、一半是无关背景,指标还是不可信。二是报告里必须把切分方式写出来,写清几块、块怎么划、每块多少样本。我审过的报告里,凡是只写“采用交叉验证、精度 0.9”而不写切分方式的,基本都要打回去重算。
八、一句话结论
先定标签,再谈模型。正样本怎么定义、负样本怎么选、切分怎么分,这三件事定完,模型选随机森林还是 XGBoost 只是收尾工作;这三件事没定,用哪个模型都是在给错误答案化妆。
如果一定要给一句可以直接执行的建议:正样本少于 100 个、只想圈可疑区、一周内要出图,用随机森林;正样本三百个以上、要在几十个候选区里排出布孔顺序、有人力和时间做嵌套验证与解释,才值得上 XGBoost;正样本不到 50 个或者标签本身站不住,两个都别用,回去把地质依据写清楚。