跑完一轮铀矿靶区预测,验证孔打下去全空,多数人的第一反应是换算法。我的经验相反:模型不好,八成是标签的问题。样本建错,后面所有工作都是在精确地犯错,算法越先进,错得越快、越像样。这篇只谈样本这一件事——正样本怎么定、负样本往哪放、类别不平衡怎么处理,三条都能当天改。
一、陷阱一·已知矿点不等于正样本
已知矿点不等于正样本。这是整套流程里最容易被跳过、也最致命的一步。
现场最常见的做法,是把矿点图层整个导出来当正样本,几十个点,跑出来的 AUC 能到 0.95,报告也漂亮。评审只问一句:这些点是怎么定的,模型就站不住了。
所以正样本入库前必须过三问。
第一问,规模够不够。工业矿体、矿化点、异常点,是三类东西,必须分开建模。混在一起,等于教模型"只要有一点异常就算成矿",学出来的边界必然比真实矿体大一圈。
第二问,可靠性如何。这个点是钻孔见矿定的,还是地表露头、物探推断、还是从邻区类比过来的?有工程控制的点才叫证据,其余只能算线索。线索可以参与建模,但不能和证据同权。
第三问,坐标精度多少。GPS 实测的点,误差在米级;从 1:20 万老地质图上量的点,图面 0.5 mm 就是实地 100 m。这类点在平面图上看不出来,一进模型就是系统性偏移。
这笔账可以算得更细。1:20 万图上 1 mm 折合实地 200 m,手工数字化时手一抖 0.3 mm,就是 60 m;再叠加底图展点误差与坐标系统转换残差,点位整体偏出百米是常事。图面上看不出任何异常,落进块体模型,正样本就压在了错误的块段上。
判断条件写死:坐标精度低于 100 m 的矿点,只做参考样本,不进训练集;只有异常依据、没有工程控制的点,单独建一类"疑似正样本",权重打五折。这两条挡掉的是最常见的一批脏标签。
铀矿还多一层麻烦:γ 异常不等于矿体。
γ 测井量的是镭的子体,不是铀本身。铀在氧化带里被淋走、镭留下,γ 就虚高;铀迁移到还原带沉淀、镭没跟上,γ 就偏低。这一对分家的程度用平衡系数 K 表示,K 取镭比铀。K 小于 0.9 叫偏铀,γ 低估铀含量,容易漏矿;K 大于 1.1 叫偏镭,γ 高估,容易把低品位段当工业孔。
判断条件:每个 γ 异常带至少取 3 个样品算 K 值,K 偏离 0.9–1.1 区间就先做校正,校正完再定标签。跳过这一步,等于把"镭的堆积"当"铀的富集"喂给模型。
二、陷阱二·随机撒负样本是最危险的默认操作
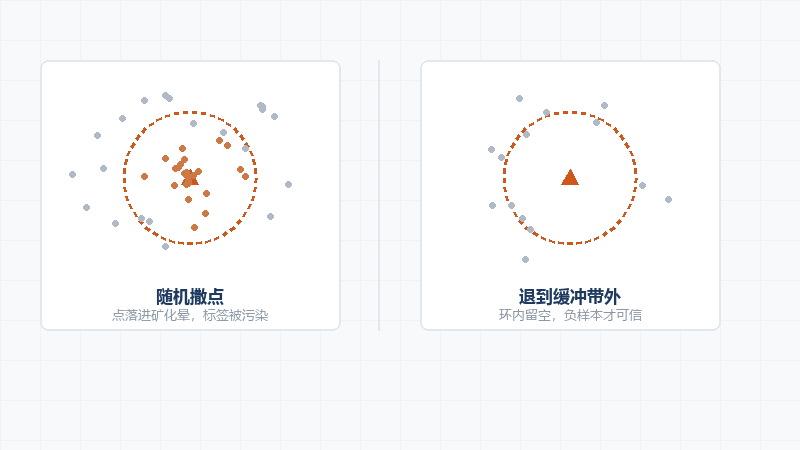
随机撒负样本,是这套方法里最危险的一个默认动作,偏偏几乎所有教程都这么教。
原因不难想:研究区里未被发现的矿体是客观存在的。你在全区随机撒点,很可能有若干个点正好落在这些未知矿体上,于是你告诉模型"这里没有矿"——而事实是"我们还不知道"。模型会认真地把这条错误规律学进去,训练集上精度很漂亮,野外验证一个不中。
正确做法只有一条主线:负样本必须退到矿化晕之外。
具体三件事。
一是设缓冲带。负样本距最近正样本的最小距离,取矿化晕半径,或者勘探线距的 2–3 倍。这个宽度按区标定,不能全省一个数。缓冲区内的点一律不用,宁可选点范围小,也不要贴着边界取点。
二是只在"勘探程度高且确认无矿"的区域取点。这句话是核心。一个区块如果只打过两个孔,没见矿,不等于无矿,只等于没查清。
三是把"确认无矿"定义清楚。三条至少满足两条:有钻孔控制且未见矿化、有系统化探且无异常、有工程揭露(坑道、浅井)见到无矿层位。只满足一条的,归入"待定",不参与训练。
判断条件也很硬:缓冲带宽度小于 1 倍勘探线距时,这批负样本整体不可信,重做;负样本落在已知异常区内的比例超过 5%,同样重做。这两个比例在选点完成后就要统计,不要等模型跑完再回头查。
还有个变体值得提防:沿剖面线等间距撒点。看起来规整、像有设计,其实只要剖面穿过异常带,点就贴着异常落,问题与随机撒点一样。
缓冲带的宽度也不能拍脑袋。做法是拿已知矿点做半变异函数,看矿化晕的实际影响范围;没有变异函数资料时,用勘探线距作替代量,取 2–3 倍。线距 100 m 的矿区,缓冲带就是 200–300 m 宽。
我吃过一次亏。一片十来平方公里的区,负样本按 500 m 网格机械铺满,看着均匀、看着"有代表性",后来验证见矿的位置,有 7 个点正好落在当初的负样本上。模型 AUC 0.93,第一轮验证全空。把负样本退到异常区外重做之后,AUC 掉到 0.78,命中率反而上来了。(示例数据,非真实项目)
这件事之后我改了流程:负样本选完先上图叠一层已知异常与物化探弱信息,肉眼过一遍,再进训练。
正样本"哪里算矿"这件事,本身依赖分带与成矿规律判断,样本建得再干净,前提错了也没用,砂岩型铀矿层间氧化带怎么圈定 那篇讲的就是这个前提怎么立。
三、陷阱三·正负 1:100 时,AUC 与准确率都会骗人
样本比例一旦到了 1:100,准确率和 AUC 都失去意义,这是很多人栽跟头的地方。
先说准确率。全判负,准确率就有 99%。这个数字拿去做汇报很好看,但它描述的是"多数类占多少",不是"模型学到了什么"。
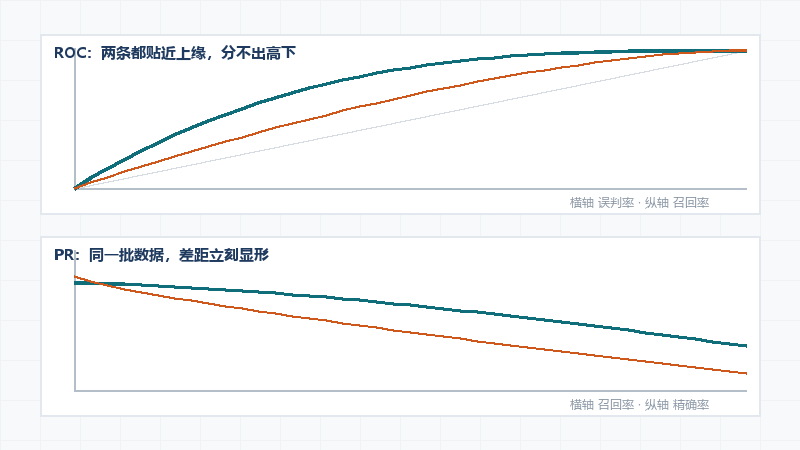
再说 AUC。AUC 衡量的是排序能力,正样本极少时它依然可以很高。原因很实在:负样本太多,随便排一排,正样本很容易被排到前面去,AUC 自然上去。模型可能只是学会了"离已知矿点近的块体更可疑",而这正是采样偏倚。
所以评估要看三样:召回率、PR 曲线、以及前 N 个候选里的命中个数。
召回率的含义是"真正的矿被找回来多少",这是勘探最关心的数。PR 曲线在不平衡数据上比 ROC 敏感得多,两条曲线一对比,模型的真实水平立刻显形。前 N 个候选命中数则是工程口径——反正一年只能打这么多孔,就问这几十个候选里能中几个。
处理不平衡有三种手段,取舍不一样。
类别权重最稳。它不改数据分布,只在损失函数里把少数类的错误放大,从 5–10 倍权重起试,观察召回率与虚警率的平衡点。首选就是它。
重采样简单但有代价。过采样重复少数类样本,等于让模型反复看同样的几个点,容易记住而不是学会;欠采样丢多数类信息,空间覆盖变稀,反而放大采样偏倚。
SMOTE 在地质数据上要非常谨慎。它的原理是在特征空间里给少数类插值造新样本。问题在于地质样本有极强的空间自相关——相邻样品的信息高度重复,插出来的"新矿点"落在特征空间合理、落在真实空间可能就是河道里、城区里,没有任何地质意义。
判断条件:正负比超过 1:20,先上类别权重并把指标换成 PR;SMOTE 只在特征彼此独立、且没有空间结构的数据上考虑;铀矿样本不建议用。
还有第四种手段常被漏掉:代价敏感学习。把漏判的代价设得比误判高,比如 10:1,模型会自动偏向"宁可多圈一点"。铀矿勘探通常就是这种场景——漏掉一个矿的代价,远大于多打几个空孔。代价比例不能随便定,一般按"一个空孔的成本 ÷ 一个漏判矿体的期望损失"估,估不出来就用 5:1 到 10:1 试,看验证结果再调。
报数也有规矩:只报召回率不报虚警率,等于只报好消息。合理的写法是三个数一起给——召回率、虚警率、候选面积。三个数放在一起,评审才知道这套模型到底能不能用。
样本量直接决定能不能上复杂模型,这条界线在 随机森林与 XGBoost 怎么选 里有更细的对比。
四、铀矿的特殊性:四层偏差叠在一起
铀矿的样本问题比一般矿种多几层,四层偏差经常同时出现。
第一层,γ 异常与铀镭不平衡。上一节说了机理,这里说它对标签的影响:偏镭区的 γ 高值段被当成正样本,是典型的假正;偏铀区的工业矿段在曲线上只是个"肩部",又成了假负。一个不平衡系数没校正,正负样本同时被污染。
第二层,钻孔密度极不均匀。老矿区孔多,新区孔少。孔多的地方资料全、异常多、被圈成矿的概率也高,模型很快学会"孔多的地方有矿"。这是采样偏倚,不是地质规律,换一个区就失效。
第三层,历史资料坐标精度低。几十年前的矿点常是图上量的,或用了地方坐标系统没转换。这类点混进来,等于给模型灌了一批位置错误的标签,而且错得毫无规律。
第四层,铀煤共生带来的标签混淆。煤层既是找矿标志,也是干扰。煤层气向上运移会把原本的氧化带二次还原成灰色,卷状矿被改造成板状、似层状,圈定形态变了,正样本的边界也跟着模糊。
对策有两条,都好执行。
一是把"勘探程度"显式建模:孔密度、化探采样密度、以往工作程度,作为一个特征,或者作为分层变量。让模型知道"这里是查过了没有矿"还是"这里根本没查"。
二是按成因类型分层建模,别把砂岩型、花岗岩型、火山岩型的点混在一个训练集里。类型不同,控矿要素完全不同,混在一起学出来的是一锅粥。
判断条件:某块段的孔密度达到全区均值的 3 倍以上,该块段正样本权重下调,或单独分层处理。
分层也有代价,每层的样本量会被摊薄。经验做法是:本区占比超过 60% 的主力类型单独建模,次要类型合并成一类,样本少于 30 的类型只做定性描述、不进概率成图。三种类型的样本都不到 20 个的时候,老老实实出一张分带图,比跑模型有用。
把三类陷阱摆在一起看,问题与对策一一对应:
表1 三类陷阱的现象、后果与对策
| 陷阱 | 典型现象 | 后果 | 对策 |
|---|---|---|---|
| 正样本定义 | 矿化点、异常点与工业矿体混在一起 | 模型学成"有异常即成矿" | 三问筛选:规模、可靠性、坐标精度;精度低于 100 m 只作参考 |
| 负样本选择 | 在全区随机撒负样本 | 撒到未发现矿体上,精度好看、验证全空 | 退到矿化晕外 2–3 倍勘探线距,只在高勘探程度区取 |
| 类别不平衡 | 正负比 1:100,仍看准确率与 AUC | 模型只学会判多数类 | 改看召回率与 PR 曲线,优先类别权重,慎用 SMOTE |
五、三条规则,直接写进作业流程
前面讲的都是判断,这一节收成三条能落到作业卡上的规则。
第一条,缓冲规则。负样本距最近正样本的最小距离不小于 2–3 倍勘探线距(或矿化晕半径),且不得落在已知异常区内。执行时先画缓冲环,再在环外布点,不要先布点再删——先布后删最容易被"这个点看着还行"说服,一松口缓冲带就失效。
落地动作有三步:算缓冲宽度、生成环外可用区、在可用区内按块段分层布点。判据是缓冲带内负样本数等于 0,以及每个块段的负样本不超过该块段的容量上限。
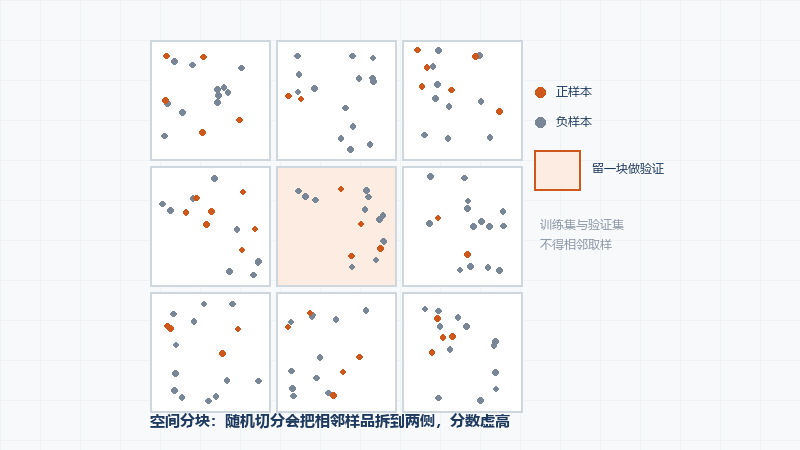
第二条,验证规则。必须用空间分块交叉验证,禁用随机 K-fold。随机切分会让相邻样品分处训练集与验证集,信息泄漏,分数虚高。判断条件很干脆:随机切分与空间分块的 AUC 差超过 0.1,只认空间分块的结果。
块的大小取勘探网度的 2–3 倍比较合适。块太小,块内样本高度相关,等于没分块;块太大,验证集样本太少,结论不稳。落地的做法是按 3×3 或 4×4 网格切,随机留一块做验证,轮完取平均。
第三条,数量规则。正样本少于 30 个,只做定性判别与有利度分级,不出概率图;30–100 个可以做概率成图,但必须给区间;超过 100 个才考虑复杂模型。这条不是保守,是算过账的:样本不足时,复杂模型输出的高概率没有任何工程价值。
三条规则之外,还有一个顺序问题:先定正样本,再选负样本,最后才谈不平衡处理。顺序反了,后面全是补丁。这也解释了一个常见现象——有人一上来就调 SMOTE 参数,调到 AUC 0.95,验证还是全空,因为问题出在他前面两步。
六、数据量与精度的取舍:减法往往比加法有效
样本这件事上,减法的收益经常高于加法,这一点与直觉相反。
常见误区是拼命凑样本量。历史矿点、邻区类比点、遥感推断点,能塞的都塞进去,样本量从 40 涨到 120,模型指标也确实好看了一点。但野外的命中率没动,因为新增的那 80 个点里,真正可靠的没几个。
我的经验值是:减掉 20% 的脏标签,往往比增加 50% 的样本更能提升野外命中率。这条是经验值,不是定理,但方向在多个项目上一致。(作者经验值,非唯一标准)
道理在成本结构上。钻探一个孔动辄几十万元,建模成本相比之下可以忽略。模型精度从 0.82 提到 0.85,在工程上几乎不值钱;把靶区面积缩小一半而命中率不掉,才真正省钱。
所以评估一套样本建得好不好,别看 AUC,看两件事:靶区面积有没有收窄,收窄之后命中率有没有掉。这两件事同时成立,样本才算建对。
判断条件:正样本里"疑似"类占比超过 30%,先停下来做标签复核,不要再加样本。
复核的产出是一张点表,六列:编号、来源(本次实测/历史资料/邻区类比)、证据类型(钻孔见矿/地表露头/物探推断)、坐标精度、是否入训、备注。这张表比任何精度指标都值钱,换人接手、三年后复查,全靠它。
复核顺序也定死:先查坐标,再查证据,最后查规模。顺序反了会白干——坐标错的点,讨论它的规模没有意义。
成本账可以算得再直白一点。一个钻孔的综合成本按几十万元计;一次建模的人工按周计,差不了太多。模型精度从 0.82 提到 0.85,换不来一个孔的位置改善;而把靶区从 20 km² 收到 8 km²、命中率不掉,省下的就是十来个孔的钱。这就是为什么样本的减法比加法值钱。
标签清洗本来就是数据治理的一部分,与 智能找矿的数据底座 里讲的多源数据核对是同一条思路:宁可少,不可错。
七、一句话结论
宁可样本少而干净,不要样本多而脏。标签错了,算法再先进也只是把错误算得更快。铀矿的样本尤其如此——γ 会撒谎,孔密度会撒谎,老图上的坐标也会撒谎。建样本的功夫,八成花在核实这三点上,而不是花在调参上。